Acer Veriton GN100 AI Mini Workstation, ASUS Ascent GX10, Dell Pro Max with GB10, GIGABYTE AI TOP ATOM, HP ZGX Nano AI Station, Lenovo ThinkStation PGX, MSI EdgeXpert MS-C931… Неймовірне різноманіття шильдиків та гучних назв! Але якщо відкинути маркетинговий шик, суть залишається єдиною — перед нами NVIDIA DGX Spark.
В автопромі це називається уніфікацією за базовим агрегатом: машини наче абсолютно різні, а відкриваєш капот — все те саме.
Кожен такий блок DGX Spark побудований на базі суперчипа NVIDIA GB10 Grace Blackwell, оснащений 128 ГБ об’єднаної (уніфікованої) пам’яті LPDDR5x (яку ділять між собою процесор та відеокарта), NVMe-накопичувачем на 4 ТБ, двома високошвидкісними мережевими портами ConnectX-7 для зв’язку між нодами та звичайним портом 10GbE RJ-45 для адміністрування.
Завдяки уніфікації ви можете збирати кластер, взагалі не дивлячись на шильдик корпусу — у такому кластері запеклі конкуренти чудово уживаються в одному ланцюжку.
Один модуль NVIDIA DGX Spark здатен «переварювати» моделі з кількістю параметрів близько 200 мільярдів (із щільним квантуванням, як-от DeepSeek V4 Flash на 284B). При прямому з’єднанні двох модулів ця межа розширюється вже до 405 мільярдів параметрів. Ну а чотири модулі — це вже зовсім інша історія.
Порівняльна таблиця конфігурацій
Кількість DGX Spark
Об’єднана пам’ять
Пропускна здатність тензорів (FP4)
Спосіб підключення
Орієнтовний розмір моделі (NVFP4)
Потрібен мережевий комутатор?
1x
128 ГБ
1 Петафлопс
Н/Д
До 200B
Ні
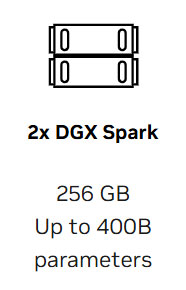
2x
256 ГБ
2 Петафлопси
Пряме QSFP-з’єднання
До 400B
Ні
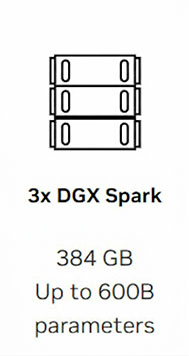
3x
384 ГБ
3 Петафлопси
Пряме QSFP-з’єднання (кільце)
До 600B
Ні
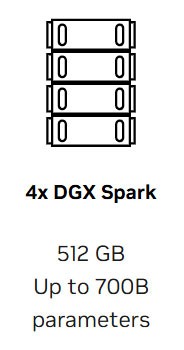
4x
512 ГБ
4 Петафлопси
Керований комутатор (від 4 портів QSFP)
До 700–800B
Так
2-вузловий кластер (2x Node)
Що знадобиться:
Дві системи DGX Spark.
Один кабель QSFP для прямого з’єднання 200GbE між пристроями.
Доступ по SSH до обох систем.
Права root або sudo на обох нодах.
Одне й те саме ім’я користувача на обох машинах.
3-вузловий кластер (3x Node)
Що знадобиться:
Як не дивно, три системи DGX Spark.
Три кабелі QSFP для прямого з’єднання пристроїв у топологію «Кільце» за протоколом 200GbE (використовуйте рекомендовані або аналогічні якісні кабелі).
Доступ по SSH та права sudo (sudo whoami) на всіх системах.
Одне ім’я користувача та оновлена до останньої версії ОС і прошивка (Firmware) на всіх трьох нодах.
Схема підключення («Кільце»):
Spark A, порт 0 ➔ Spark B, порт 1
Spark B, порт 0 ➔ Spark C, порт 1
Spark C, порт 0 ➔ Spark A, порт 1
4-вузловий кластер (4x Node)
Що знадобиться:
Чотири системи DGX Spark (до речі, ця інструкція підійде для будь-якої кількості пристроїв, що підключаються через світч).
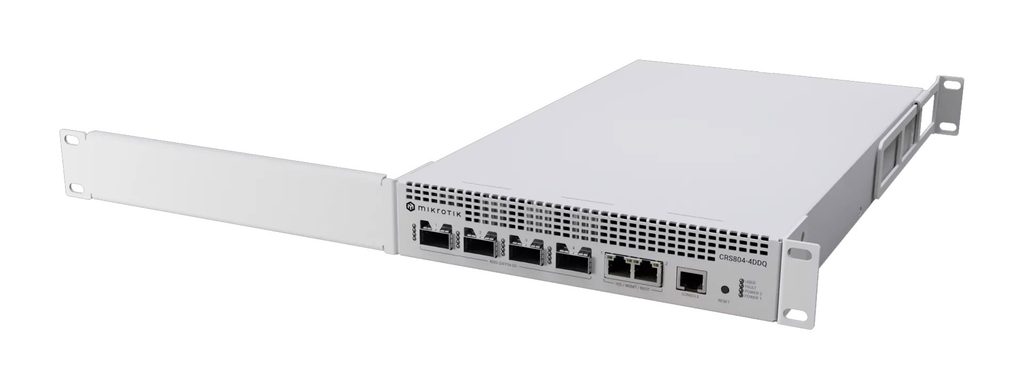
Керований QSFP-комутатор щонайменше на 4 порти (кожен не менше 200 Гбіт/с). Ідеальний кандидат у співвідношенні ціна/можливості — MikroTik CRS804-4DDQ-HRM.
Один кабель на кожен Spark для підключення до комутатора.
Доступ по SSH, sudo-права, єдиний юзер та оновлена система на всіх чотирьох вузлах.
💡 Важливий нюанс щодо кабелів для MikroTik CRS804: Оскільки порти на CRS804 — це не стандартні роз’єми QSFP112, а фізично глибші порти QSFP56-DD, на практиці є два шляхи:
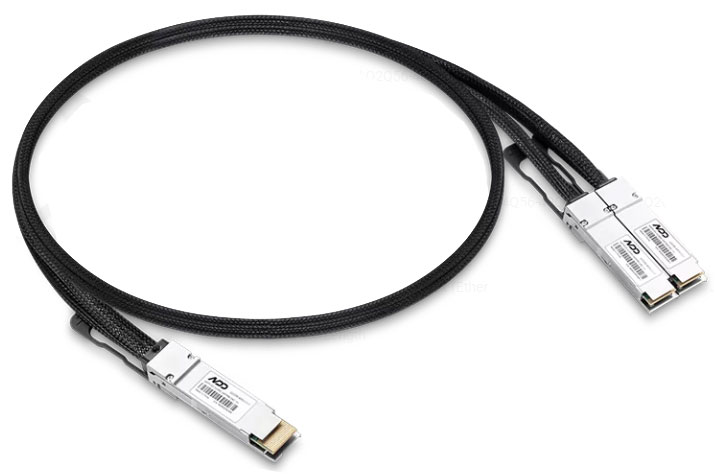
400G DAC QSFP-DD 8x50G PAM4 to 2x200G QSFP56 4x50G PAM4 Passive Direct Attach Copper Breakout Cable
4 кабелі QSFP на QSFP56-DD: Стандартне пряме підключення кожного з чотирьох DGX Spark до комутатора.
2 разветвительні (breakout) кабелі 2x QSFP на QSFP56-DD: Такий кабель ділить один порт 400G на комутаторі на два порти по 200G. Це займає всього 2 порти на комутаторі та потенційно дозволяє підключити до 8 пристроїв DGX Spark до одного MikroTik CRS804!
MikroTik CRS804-4DDQ-HRM
Налаштування комутатора: виставляємо швидкість ручками
Після прокладання кабелів зайдіть в адмінку CRS804 і примусово виставте швидкість кожного задіяного порту на 200 Гбіт/с, не покладаючись на автоузгодження (Auto-Negotiation). У документації NVIDIA Cluster Assistant про це написано прямим текстом.
Не лякайтеся: якщо під час запусків бенчмарків ви побачите реальну пропускну здатність близько 100 Гбіт/с на канал — це не помилка конфігурації. Це фізичне обмеження лінії PCIe Gen5 x4 всередині кожного порту ConnectX-7, а не проблеми зі світчем.
NVIDIA Sync Cluster Assistant: рятувальний круг для розробника
Мережеві карти ConnectX-7 у системах DGX Spark мають свою специфіку, і налаштування мережі вручну — це той ще квест із купою консольних команд та скриптів.
Щоб ви розуміли глибину магії:
Мережева карта знаходиться між зовнішніми портами QSFP та чипом (SoC) Grace Blackwell.
Вона підключена до SoC через два незалежні канали PCIe Gen 5 x4.
Через це кожен порт QSFP має дві адреси PCIe.
Як результат, у Linux кожен фізичний порт QSFP відображається як два окремих мережевих інтерфейси (підключаєте 2 кабелі — бачите 4 інтерфейси у системі).
Кожен такий інтерфейс має відповідний пристрій RoCE для роботи в мережі InfiniBand.
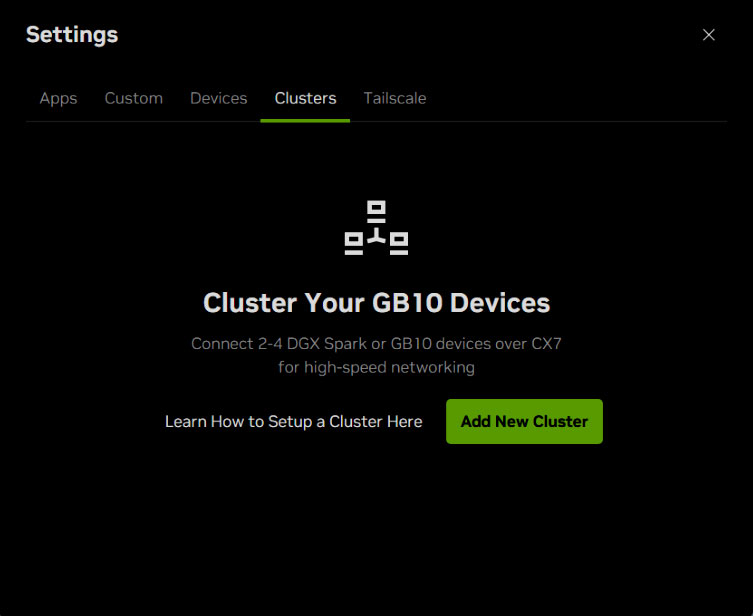
На щастя, NVIDIA змилувалася над юними кластеробудівниками. Інструмент NVIDIA Sync Cluster Assistant робить майже всю брудну роботу автоматично: знаходить ноди, налаштовує ConnectX-7, розподіляє IP-адреси, перевіряє зв’язок та прокидає авторизацію по SSH без паролів.
Зауважте: Cluster Assistant налаштовує саме мережеву інфраструктуру. Запуск самих моделей, налаштування паралелізму та інференс-сервісів вам все одно доведеться робити самостійно.
Замість висновків
Чотиривузловий кластер із сумарним споживанням близько 1200 Вт легко живиться від звичайної домашньої розетки. До того як починати збирати мільйони на великі промислові стійки DGX, кластер з 4× DGX Spark — це найрозумніший спосіб затестувати багатовузловий інференс та мультиагентні системи на дійсно величезних моделях.
Маючи під рукою такий 4-нодовий сетап із 512 ГБ об’єднаної пам’яті, ви можете комфортно реалізувати такі сценарії:
Запуск одного монстра, що влазить тільки на 4 вузли: Модель рівня DeepSeek-R1 671B (у 4-бітному квантуванні). Це той самий клас «~700B», який фізично не запустити на 1–2 нодах, але який чудово оживає на 512 ГБ пам’яті (за умови грамотного конвейєрного або тензорного паралелізму).
Паралельний запуск кількох середніх моделей (найкращий кейс для продакшену): Наприклад, запуск 4 незалежних інстансів Llama 3 70B (по одному на кожен вузол) для обробки запитів різних користувачів/агентів, або мікс з 2× Llama 3 70B + 2× Qwen2.5 32B під комбіновані задачі (кодинг + чат + RAG).